FlashPPI 使用指南:蛋白质相互作用检索、接触评分与结果检查
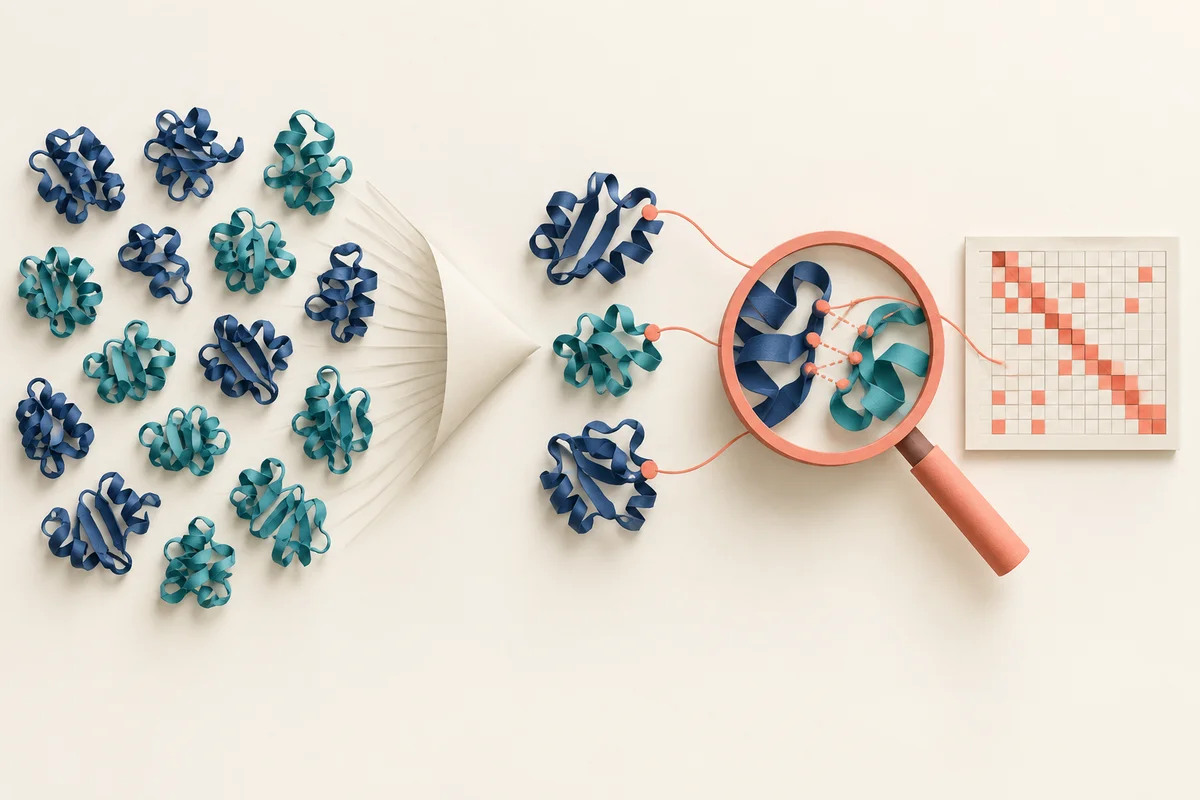
对蛋白质组中的每一对蛋白都进行筛查,计算量会迅速增加。4,000 个蛋白在不考虑自相互作用时,就有 7,998,000 个不同的无序配对。FlashPPI 先利用蛋白质向量检索可能的伙伴,再把较昂贵的接触预测用于检索得到的候选。
本文解释方法、核查公开推理代码,并提供一个小型 CSV 检查工具。资料核查日期为 2026 年 10 月 8 日。原始研究是 Cornman 等人于 2026 年发表的 PNAS 论文。下文推理流程经过源码核对;本文没有运行 GPU 模型,也没有复现论文基准。
1. 从蛋白质序列到候选相互作用
FlashPPI 使用基因组语言模型 gLM2 初始化共享编码器,通过对比学习和困难负样本,将蛋白质层面的检索表示与残基层面的接触预测一起训练。论文主要研究微生物蛋白质相互作用。见原始研究。
实际使用时,应区分三种输出:
| 输出 | 用途 | 不能据此确认什么 |
|---|---|---|
| 检索相似度 | 选择需要进一步评分的候选伙伴 | 实验验证的结合关系 |
| 接触图 | 估计可能接触的残基对 | 已解析的三维复合物结构 |
contact_score |
根据最强预测接触,对候选排序或过滤 | 真实相互作用的校准概率 |
公开模型中的接触分数,是有效残基对中最大的预测接触概率。单蛋白质组脚本先取有效接触 logit 的最大值,再执行 sigmoid,聚合含义相同。因此,分数接近 1 并不代表实验确认率为 99%。
这与 OmegaTherm 的突变稳定性预测是不同任务:FlashPPI 关注可能的蛋白质伙伴及其界面,而不是突变引起的 ΔΔG 或 ΔTm 变化。
2. 如何理解论文性能数字
论文图 2 在独立的 E. coli K12 基准上报告 FlashPPI 的 AUPRC 为 0.29,PLM-Interact 为 0.07,正负样本比例为 1:100。运行时间比较使用单张 NVIDIA A100。这些是作者结果,不是本文测得的数据。见论文及图 2。
阅读数字时,要同时考虑物种、负样本构造和阳性比例。AUPRC 不是准确率,这个基准上的结果也不能证明模型对任意真核蛋白、抗体与抗原配对或其他实验条件具有同样表现。
自己的评估既要检查检索能否保留已知伙伴,也要检查最终分数是否能正确排序。检索阶段漏掉的配对不会进入接触预测。使用独立评估集,并关注实际有能力进一步验证的候选数量下的精确率。
3. 公开流程中的“线性时间”具体指什么
当检索深度 k 固定时,昂贵的接触预测阶段大约处理 N × k 个有方向候选,而不必处理所有蛋白配对。这是主要的计算缩减。每个候选的开销仍受序列长度和批量设置影响。
需要明确一个实现细节:核查的单蛋白质组脚本使用 FAISS IndexFlatIP。FAISS 将它定义为穷举内积检索。在固定向量维度下,对 N 个存储向量执行 N 次查询,向量比较量仍是二次增长。因此,公开脚本并没有让每个步骤都严格线性;它缩减的是更昂贵的接触推理工作量。
增大 --stage1_top_k 可能保留更多潜在伙伴,同时增加接触预测开销。脚本请求 k + 1 个邻居后移除自身命中,因此实际数量未必恰好等于 N × k。应查看日志中的候选数。
4. 准备可复现的本地试运行
官方仓库提供基于 GPU 的筛查流程。建议先用小型蛋白质 FASTA 和支持 CUDA 的机器。代码包含 CPU 回退路径,但本文没有验证它的性能或兼容性。仓库将 Flash Attention 列为可选项;下文输出检查工具不需要它。
核查的代码提交为 bb75bb1a960b3c8325a643b5cd7d7c11e41b5a0f:
git clone https://github.com/TattaBio/FlashPPI.git
cd FlashPPI
git checkout bb75bb1a960b3c8325a643b5cd7d7c11e41b5a0f
python3 -m venv .venv
. .venv/bin/activate
python -m pip install -r requirements.txt
python predict_proteome.py --help
依赖使用最低版本约束,没有完整锁定环境。应选择适合 GPU 的 Python 和 PyTorch 构建,并记录实际成功运行的版本。
脚本默认从 Hub 解析 tattabio/flashppi。为了同时固定模型版本,将以下代码保存为仓库根目录中的 download_model.py,运行 python download_model.py:
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="tattabio/flashppi",
    revision="f6238ca5e5814d8a39b7e07822e9c35d5dc00b35",
    local_dir="weights/flashppi",
    allow_patterns=["*.json", "*.py", "*.safetensors"],
)
该版本已与官方模型仓库核对。这里会下载模型权重,不只是小型配置文件。Hugging Face 的下载指南说明了 revision、local_dir 和文件过滤参数。上游加载器使用 trust_remote_code=True,会执行该快照中的模型实现代码。
5. 执行单蛋白质组筛查
将蛋白质 FASTA 放在仓库根目录,命名为 my_proteome.fasta。记录 ID 应唯一,氨基酸序列非空,并至少包含两条记录。脚本使用 Biopython 的记录 ID 生成输出;不要依靠空白之后的描述文字区分记录。本站的 FASTA 检查教程可作为起点。
创建新的输出目录并启动:
mkdir flashppi-run-001 && \
python predict_proteome.py \
  --fasta my_proteome.fasta \
  --model_name weights/flashppi \
  --output flashppi-run-001/predictions.csv \
  --stage1_top_k 100 \
  --threshold 0.5 \
  --batch_size 4 \
  --max_len 1024 \
  > flashppi-run-001/run.log 2>&1
如果目录已经存在,mkdir 会报错,&& 会阻止模型命令继续执行。这有助于避免把旧预测文件误认为新结果。进程结束后查看 flashppi-run-001/run.log。
主要参数如下:
| 参数 | 核查版本中的作用 |
|---|---|
--stage1_top_k |
控制接触评分前的检索深度,默认 100 |
--threshold |
仅保留严格大于阈值的分数,默认 0.5 |
--batch_size |
控制编码和接触预测批量;示例用 4,默认是 64 |
--max_len |
启用截断时的 tokenizer 最大长度,默认 1024 |
这些是软件设置,不是经过验证的生物学阈值。运行前应检查长序列,因为截断可能移除相关区域。减小批量可能降低内存需求,但单蛋白质组脚本会将全部残基表示保留在所选设备上,不能消除随蛋白质组大小增长的缓存。见固定版本实现。
6. 理解 CSV 与没有输出文件的情况
单蛋白质组结果包含 query_id、match_id、contact_score。脚本在候选构建时移除自身命中,合并正反顺序配对,每个无序配对保留最大分数,最后按分数排序。
如果没有候选超过阈值,程序会打印提示,不会写出 CSV。指定路径中原有的文件也会保留。应同时检查进程退出状态和日志;仅凭文件不存在,无法区分正常的空结果和运行失败。这些行为可见于输出代码。
单独的跨蛋白质组脚本具有不同约定:它用病毒蛋白查询宿主与病毒的合并候选库,每个查询最多保留一个超过阈值的最佳宿主命中。默认阈值为 0.4,列名包含 viral_id、host_id 和 host_is_best_contact。该标记比较的是已检索且完成接触评分的候选,不代表全局生物学最佳伙伴。下文检查工具只处理单蛋白质组 CSV。
7. 使用报告前先做检查
下载 check_flashppi_output.py,需要 Python 3.10 或更新版本,无外部依赖。以下演示使用仅用于测试报告格式的虚构分数:
python3 check_flashppi_output.py --help
cat > example_predictions.csv <<'CSV'
query_id,match_id,contact_score
p1,p2,0.91
p2,p3,0.72
CSV
python3 check_flashppi_output.py example_predictions.csv
预期输出:
{
  "edges": 2,
  "proteins_in_edges": 3,
  "min_contact_score": 0.72,
  "max_contact_score": 0.91
}
请在临时工作目录中执行,因为 cat > 会覆盖示例文件。真实任务中,将检查工具的参数换成实际 predictions.csv 路径。proteins_in_edges 只统计保留边中出现的蛋白,不是整个蛋白质组,也不包含孤立节点。
"""Check a FlashPPI single-proteome CSV; no model inference or biological validation."""
import argparse
import csv
import json
import math


def summarize(path):
    pairs = set()
    nodes = set()
    minimum = maximum = None
    with open(path, encoding="utf-8-sig", newline="") as handle:
        reader = csv.reader(handle, strict=True)
        if next(reader, None) != ["query_id", "match_id", "contact_score"]:
            raise ValueError("Expected query_id,match_id,contact_score header in that order")
        for number, row in enumerate(reader, start=1):
            if len(row) != 3:
                raise ValueError(f"Record {number}: expected 3 fields")
            query, match, text_score = row
            if any(not value or value != value.strip() for value in (query, match)):
                raise ValueError(f"Record {number}: empty or padded ID")
            if query == match:
                raise ValueError(f"Record {number}: self-pair")
            score = float(text_score)
            if not math.isfinite(score) or not 0 <= score <= 1:
                raise ValueError(f"Record {number}: score must be finite and in [0, 1]")
            pair = tuple(sorted((query, match)))
            if pair in pairs:
                raise ValueError(f"Record {number}: duplicate undirected pair")
            pairs.add(pair)
            nodes.update((query, match))
            minimum = score if minimum is None else min(minimum, score)
            maximum = score if maximum is None else max(maximum, score)
    return {"edges": len(pairs), "proteins_in_edges": len(nodes),
            "min_contact_score": minimum, "max_contact_score": maximum}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("input", help="single-proteome predictions CSV")
    args = parser.parse_args()
    try:
        result = summarize(args.input)
    except (OSError, UnicodeError, ValueError, csv.Error) as exc:
        parser.exit(1, f"error: {exc}\n")
    print(json.dumps(result, indent=2, allow_nan=False))


if __name__ == "__main__":
    main()
工具拒绝字段错误、非有限或越界分数、自配对,以及重复无序配对。仅有表头的报告被视为零条边,不过上游的无命中分支不会创建这种文件。它不检查 ID 是否属于输入 FASTA、文件是否来自本次运行,也不验证相互作用是否真实。配对与节点集合占用的内存会随报告大小增长。
六项测试已经通过,包括 10,000 条边的报告、带引号的 ID、反向重复配对、非法分数和 CLI 错误处理。这验证的是检查工具,不是 FlashPPI 的生物学准确率。
8. 排错与后续分析
| 现象 | 处理方法 |
|---|---|
| 没有预测文件 | 检查退出状态和日志中的无命中提示,并使用新的运行目录。 |
| CUDA 内存不足 | 降低批量、检查序列长度,同时考虑保留的残基缓存。 |
| 候选配对少于预期 | 检查检索深度、自身命中移除及实际蛋白数量。 |
| 蛋白名称看起来重复 | 推理前确保 FASTA 记录 ID 唯一。 |
| 分数高但没有实验支持 | 检查接触图,并采用合适的独立实验验证候选。 |
| 跨蛋白质组 CSV 被检查工具拒绝 | 使用与该脚本不同输出格式相匹配的分析。 |
如需交互探索,官方模型卡链接了 SeqHub,可通过 FASTA 进行网络和接触图探索。需要明确版本与可复现输出处理时,可以采用本地流程。
9. 小结
FlashPPI 先检索候选,把详细接触预测集中到可管理的配对集合。固定代码和模型版本,检查检索与截断设置,并按实际聚合方式理解接触分数。将候选筛查与实验确认分开,在构建下游分析前核对输出约定。
- 原文作者:春江暮客
- 原文链接:https://www.bobobk.com/flashppi-protein-interaction-guide.html
- 版权声明:本作品采用 知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。