用 Python 检查文件名大小写和 Unicode 冲突:跨机器复制前的只读预检
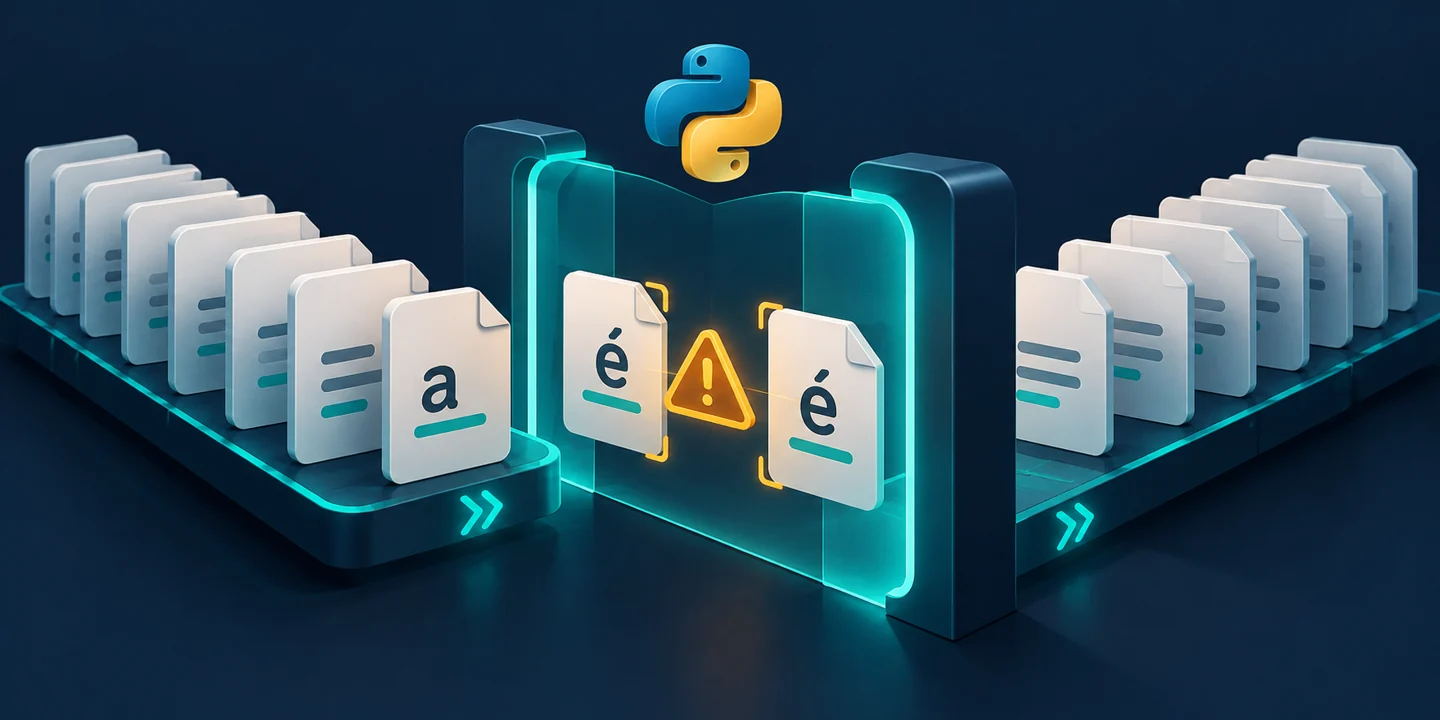
把项目从 Linux 复制到另一台电脑后,README.md 和 readme.md 可能不再能作为两份独立文件使用;看起来一样的 café.txt 也可能使用不同的 Unicode 编码序列。先检查名字,再打包或搬运,比复制后排查丢文件更容易。
本文面向初级到中级读者,用 Python 标准库制作只读文件名预检工具:找出同目录下按约定规则等价的名字,输出 JSON,并用退出码阻止后续自动化。它不改名、不删除文件,也不修改 Hugo 配置。
1. 方法:定义一个保守的名字比较规则
- 每个文件名先做 NFC 规范化,再
casefold(),最后再次做 NFC,得到比较键。 - 只比较同一个目录的直接条目,包括文件、目录、隐藏条目和符号链接名字;递归进入真实子目录,但不进入目录链接。
- 同键的多个名字作为一个候选冲突组。不同目录里的同名文件不算冲突;父目录名字冲突本身会被报告,但不合并两个目录再比较后代。
Python 官方 Unicode 文档说明 NFC 会组合规范等价的序列;官方 casefold() 文档说明其处理范围比小写转换更广,例如 ß 会变成 ss。这是本教程选择的保守预检规则,不是任何特定文件系统的精确模拟,可能产生需要人工确认的提示。
它也不检查 Windows 保留名、尾随点、非法字符、路径长度、视觉相似字符或 Hugo front matter 中重复的 url。零冲突不等于所有平台兼容;发布站点时还要运行 Hugo 站内链接和图片检查。
2. 准备:在独立目录创建样例
需要 Linux、Python 3.9 或更新版本和 bash/zsh,无需安装依赖。本文在 Python 3.11.4 上测试。样例要求大小写敏感、且不自动合并这两种 Unicode 名字的文件系统;重复练习请换新目录名,避免覆盖旧样例。
python3 --version
mkdir filename-audit-demo
cd filename-audit-demo
python3 - <<'PY_DATA'
from pathlib import Path
root = Path("sample")
(root / "assets").mkdir(parents=True)
for name in ["README.md", "readme.md"]:
    (root / name).write_text(name + "\n", encoding="utf-8")
for name in ["caf\u00e9.txt", "cafe\u0301.txt"]:
    (root / "assets" / name).write_text("demo\n", encoding="utf-8")
assert len(list(root.glob("*.md"))) == 2, "use a case-sensitive demo filesystem"
assert len(list((root / "assets").iterdir())) == 2, "Unicode names were merged"
PY_DATA
两条断言应通过;如果失败,停止练习并换到支持这些独立名字的演示目录,不要在真实项目里制造冲突。
3. 实现:扫描名字,不读取文件内容
把完整代码保存为当前目录下的 check_names.py,也可下载脚本。
"""Read-only sibling filename collision preflight. Python 3.9+."""
import argparse
import json
import os
from pathlib import Path
import sys
import unicodedata


def name_key(name):
    return unicodedata.normalize(
        "NFC", unicodedata.normalize("NFC", name).casefold()
    )


def audit(root):
    if not root.is_dir():
        raise ValueError("root must be an existing directory")
    groups = []
    pending = [root]
    while pending:
        directory = pending.pop()
        by_key = {}
        with os.scandir(directory) as entries:
            for entry in entries:
                by_key.setdefault(name_key(entry.name), []).append(entry.name)
                if entry.is_dir(follow_symlinks=False):
                    pending.append(Path(entry.path))
        for names in by_key.values():
            if len(names) > 1:
                groups.append({
                    "directory": directory.relative_to(root).as_posix(),
                    "names": sorted(names),
                })
    groups.sort(key=lambda item: (item["directory"], item["names"]))
    return {"collision_groups": len(groups), "groups": groups}


def main():
    cli = argparse.ArgumentParser(description=__doc__, allow_abbrev=False)
    cli.add_argument("root", type=Path, help="quiet local directory to scan")
    args = cli.parse_args()
    try:
        report = audit(args.root)
    except (OSError, ValueError) as exc:
        print(f"ERROR: {exc}", file=sys.stderr)
        return 2
    print(json.dumps(report, ensure_ascii=True, sort_keys=True))
    return 1 if report["collision_groups"] else 0


if __name__ == "__main__":
    raise SystemExit(main())
os.scandir() 官方文档介绍目录条目与 is_dir(follow_symlinks=False)。这里用上下文管理器关闭目录迭代器,不忽略目录读取和类型查询错误;失败就不输出一份看似完整的成功报告。
请扫描可信且暂停变更的本地目录。根路径按调用方给出的路径解析,根本身可以是目录链接;子链接不递归。代码不是原子快照,不能防御扫描期间目录被替换,真实目录下的挂载点也会被扫描。内存主要取决于待扫描目录数、单目录条目数和冲突报告规模。
4. 使用:先报告,再人工处理
- 查看帮助,再检查样例。不要把后两条命令放进启用了
set -e的脚本,因为预期退出码为 1:
python3 check_names.py --help
python3 check_names.py sample
printf 'exit=%s\n' "$?"
预期输出:
{"collision_groups": 2, "groups": [{"directory": ".", "names": ["README.md", "readme.md"]}, {"directory": "assets", "names": ["cafe\u0301.txt", "caf\u00e9.txt"]}]}
exit=1
JSON 使用 ASCII 转义,便于区分组合字符;\u0301 是组合重音,\u00e9 是预组合字符。报告中的原名字才是实际路径,不要拿规范化比较键直接覆盖文件名。
- 确认两份文件确实应保留后,只改演示目录中的名字。真实项目应先备份、核对内容并同步更新引用;需要内容证据可参考 SHA-256 数据清单检查。
mv sample/readme.md sample/notes.md
python3 - <<'PY_FIX'
from pathlib import Path
source = Path("sample/assets/cafe\u0301.txt")
target = source.with_name("cafe-notes.txt")
assert not target.exists()
source.rename(target)
PY_FIX
python3 check_names.py sample
printf 'exit=%s\n' "$?"
此时应输出 {"collision_groups": 0, "groups": []} 和 exit=0。目录链接的目标检查是另一个问题,可使用 Python 失效符号链接扫描。
5. 验证:退出码和只读行为
完成上一节改名后运行以下测试,只在演示目录新增测试条目;重复运行请重建整个演示目录。
python3 - <<'PY_TEST'
import json
from pathlib import Path
import subprocess
import sys

root = Path("sample")
# Add a nested directory that must NOT be followed through a symlink.
outside = Path("outside")
outside.mkdir()
for name in ["A.txt", "a.txt"]:
    (outside / name).write_text("outside\n", encoding="utf-8")
(root / "external").symlink_to(outside.resolve(), target_is_directory=True)
(root / "missing-link").symlink_to("not-created")
(root / ".hidden").mkdir()
(root / ".hidden" / "ONLY.txt").write_text("hidden\n", encoding="utf-8")

def run(path):
    return subprocess.run(
        [sys.executable, "check_names.py", str(path)],
        capture_output=True, text=True, check=False,
    )

before = {str(p): p.read_bytes() for p in root.rglob("*")
          if not p.is_symlink() and p.is_file()}
result = run(root)
assert result.returncode == 0 and result.stderr == "", result
assert json.loads(result.stdout)["collision_groups"] == 0
print("PASS: clean tree; symlink targets not scanned")
(root / ".hidden" / "only.txt").write_text("second\n", encoding="utf-8")
result = run(root)
assert result.returncode == 1 and result.stderr == "", result
assert json.loads(result.stdout)["groups"] == [
    {"directory": ".hidden", "names": ["ONLY.txt", "only.txt"]}
]
print("PASS: hidden directory collision")
for bad in [root / "not-created", root / "notes.md"]:
    result = run(bad)
    assert result.returncode == 2 and not result.stdout
    assert result.stderr.startswith("ERROR:"), result
print("PASS: missing root and file root rejected")
assert all(Path(p).read_bytes() == data for p, data in before.items())
print("PASS: existing file contents unchanged")
PY_TEST
应看到四行 PASS。测试确认隐藏目录会被遍历、外部目录链接不会被跟随、缺失根路径和普通文件根路径会失败,已有文件内容保持不变。
退出码约定:0 表示扫描完整且没有候选组;1 表示扫描完整但发现候选组;2 表示扫描或命令行错误。扫描错误写 stderr,stdout 为空。可以把检查放在后续动作前:
python3 check_names.py sample > filename-report.json && printf 'preflight passed\n'
验证测试留下了隐藏目录冲突,因此上面命令此时会返回 1,不会打印成功提示;先人工处理冲突,再重新运行。失败时重定向创建的报告可能为空,调用方必须同时检查退出码。
6. 排障:别把预检当作自动修复
| 现象 | 原因与具体处理 |
|---|---|
root must be an existing directory |
路径不存在或是文件;用 pwd 确认位置,再传入真实目录的绝对路径。 |
Permission denied |
某个目录无法读取或遍历;用 ls -ld 检查报错路径及父目录,请目录所有者授权最小必要权限,不要用 chmod -R 777。 |
| 名字看起来一样 | 查看 JSON 中的转义序列;根据内容和引用选择明确的新名字,不要删除其中一份来“消除提示”。 |
ß 与 ss 被分成同组 |
这是 casefold 的策略;人工确认目标平台需求,不代表当前 Linux 已有同名文件错误。 |
| 链接目标里明明有冲突却没报告 | 工具只比较链接名字,不扫描其目标;另行检查目标目录,避免扩大扫描边界。 |
7. 总结
先用 NFC 与 casefold 找出候选冲突,再人工确认名字和引用,能给跨机器复制、备份和静态资源整理增加一道明确的预检。保留 0、1、2 三种结果,避免把扫描失败误当作没有冲突。它不替代目标文件系统实测、内容校验或 Hugo 构建检查。
- 原文作者:春江暮客
- 原文链接:https://www.bobobk.com/python-filename-case-unicode-collisions.html
- 版权声明:本作品采用 知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。