用 Python 按时间合并多份日志:heapq.merge、时区与乱序检查
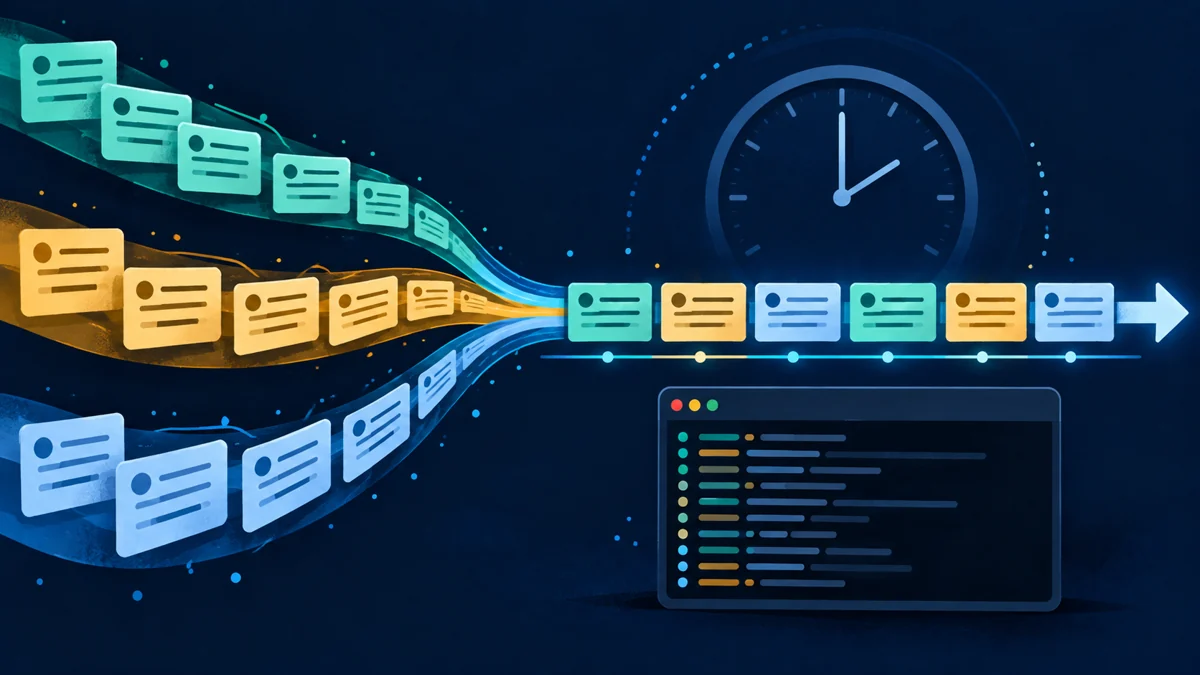
多台 worker 的日志各自按时间写入,直接用 cat 拼接后,故障前后顺序就乱了;先把全部行读入列表再排序,又会增加内存占用。本文面向初学者到中级读者,用 Python 标准库 heapq.merge 合并已经排好序的日志,输出带 UTC 时间、来源路径和行号的 JSONL。
这里只处理已经写完、读取期间不再变化的普通 UTF-8 文件。输入格式是“一行一个时间戳、一个空格、非空消息”,时间戳内部不含空格,例如 2026-10-28T08:00:00+08:00 task started;多行堆栈要先整理为单行事件。如果只想检查一份日志的末尾,可以先用 deque 日志末尾读取方法。
1. 方法:先统一时刻,再归并有序输入
- 解析带
Z或 UTC 偏移量的时间戳,转换到 UTC;不按原始字符串排序。 - 检查每份日志的时间是否非递减,遇到倒退就报错;相同时间允许重复。
- 逐条归并到临时文件,全部读取和校验成功后,才创建新的输出文件。
heapq.merge 官方文档说明,它返回迭代器,要求每路输入已经有序,不会一次加载全部记录。它不会替你把单份乱序日志排好序。本工具在相同时刻按命令行输入文件顺序、原始行号决定顺序,不去重,也不推断事件的因果关系。
归并只保留少量候选记录,但单行仍可能很长;这里没有固定的字节级内存上限。临时文件需要能容纳完整 JSONL,复制到最终文件时还需要额外空间。工具最多接受 64 份输入,同时保持这些文件打开;实际系统限制可能更低。
2. 准备:创建两份可重复的日志
需要 Python 3.11 或更新版本,不安装第三方包。示例已在 Linux、Python 3.11.4 上测试,命令适用于 bash 和 zsh。请在新的可写目录实验,后续步骤保持在同一目录;重复实验时换一个目录名。
- 创建两份有序输入,故意使用不同偏移量:
python3 --version
mkdir merge-logs-demo
cd merge-logs-demo
cat > worker-a.log <<'EOF'
2026-10-28T08:00:00+08:00 alpha started
2026-10-28T08:00:02+08:00 alpha finished
EOF
cat > worker-b.log <<'EOF'
2026-10-28T00:00:00Z beta started
2026-10-28T00:00:01Z beta finished
EOF
- 将下一节代码保存为
merge_logs.py。
Python 3.11 的 datetime.fromisoformat()支持样例中的 Z。这里把带时区的值转换成 UTC 后比较,避免把北京时间 08:00 排到同一时刻的 UTC 00:00 后面;没有时区的记录会被拒绝。需要按本地日期做日报时,再参考 zoneinfo 日志日期统计。
3. 实现:校验成功后才创建输出
"""Merge completed, sorted UTF-8 logs into new JSONL output. Python 3.11+."""
import argparse
from contextlib import ExitStack
from datetime import datetime, timezone
import heapq
import json
from pathlib import Path
import shutil
import sys
import tempfile


def records(source, path, index):
    previous = None
    for number, raw in enumerate(source, 1):
        text = raw.rstrip("\n")
        stamp, separator, message = text.partition(" ")
        try:
            if not separator or not message:
                raise ValueError("expected TIMESTAMP message")
            instant = datetime.fromisoformat(stamp)
            if instant.tzinfo is None or instant.utcoffset() is None:
                raise ValueError("timestamp needs Z or a UTC offset")
            instant = instant.astimezone(timezone.utc)
            if previous is not None and instant < previous:
                raise ValueError("timestamps go backwards")
        except (ValueError, OverflowError) as exc:
            raise ValueError(f"{path}:{number}: {exc}") from exc
        previous = instant
        yield instant, index, number, message


def merge_logs(paths, output):
    if not 1 <= len(paths) <= 64:
        raise ValueError("provide 1..64 input files")
    resolved = [path.resolve() for path in paths]
    if len(set(resolved)) != len(resolved):
        raise ValueError("input paths must be distinct")
    if output.resolve() in resolved:
        raise ValueError("output must differ from every input")
    count = 0
    with ExitStack() as stack:
        streams = []
        for index, path in enumerate(paths):
            source = stack.enter_context(path.open(encoding="utf-8", errors="strict"))
            streams.append(records(source, path, index))
        with tempfile.TemporaryFile(
            mode="w+", encoding="utf-8", newline="\n", dir=output.parent
        ) as scratch:
            for instant, index, number, message in heapq.merge(*streams):
                row = {"time": instant.isoformat(), "source": str(paths[index]),
                       "line": number, "message": message}
                scratch.write(json.dumps(row, ensure_ascii=False) + "\n")
                count += 1
            scratch.seek(0)
            created = False
            try:
                with output.open("x", encoding="utf-8", newline="\n") as target:
                    created = True
                    shutil.copyfileobj(scratch, target)
            except BaseException:
                if created:
                    output.unlink()
                raise
    return count


def main():
    parser = argparse.ArgumentParser(description=__doc__, allow_abbrev=False)
    parser.add_argument("inputs", nargs="+", type=Path)
    parser.add_argument("-o", "--output", type=Path, required=True)
    args = parser.parse_args()
    try:
        count = merge_logs(args.inputs, args.output)
    except (OSError, UnicodeError, ValueError) as exc:
        print(f"ERROR: {exc}", file=sys.stderr)
        return 2
    print(json.dumps({"records": count, "output": str(args.output)}))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
ExitStack 官方示例展示了如何管理数量不固定的上下文资源。这里即使后续输入打开失败,已经打开的文件也会被关闭。临时文件放在输出目录,退出上下文时自动关闭清理;输出的父目录必须提前存在。
输出以 x 模式创建:已有文件、符号链接及指向输入的路径都会失败,不会覆盖旧结果。可捕获的读取或格式错误发生在创建输出之前;复制时发生异常会尝试删除本次创建的输出。最终复制不是原子发布,其他进程应等待退出码为 0 后再读取;强制终止或断电仍可能留下半成品。此工具用于可信本地目录,不处理并发替换路径的情况。
4. 使用:检查合并顺序与来源
- 查看帮助、归并并断言结果:
python3 merge_logs.py --help
python3 merge_logs.py worker-a.log worker-b.log -o merged.jsonl
python3 - <<'PYCODE'
import json
from pathlib import Path
rows = [json.loads(line) for line in Path("merged.jsonl").read_text(encoding="utf-8").splitlines()]
assert [r["message"] for r in rows] == [
    "alpha started", "beta started", "beta finished", "alpha finished"
]
assert rows[0]["time"] == rows[1]["time"] == "2026-10-28T00:00:00+00:00"
assert [r["line"] for r in rows] == [1, 1, 2, 2]
print("PASS: merged timeline and source line numbers")
PYCODE
成功报告为 {"records": 4, "output": "merged.jsonl"},随后输出 PASS: merged timeline and source line numbers。JSONL 的每行包含 time、source、line、message;消息里的引号和反斜杠由 JSON 编码处理。换行统一为 LF,末行没有换行也能读取,输出每条记录都有换行。
- 故意提供一份倒序日志:
cat > backwards.log <<'EOF'
2026-10-28T00:00:03Z later
2026-10-28T00:00:01Z earlier
EOF
python3 merge_logs.py worker-a.log backwards.log -o rejected.jsonl
printf 'exit=%s\n' "$?"
python3 -c 'from pathlib import Path; assert not Path("rejected.jsonl").exists()'
预期错误包含 backwards.log:2: timestamps go backwards,退出码为 2,且没有 rejected.jsonl。不要使用 || true 隐藏失败;在启用了 set -e 的脚本里,这个故意失败的命令会让脚本提前结束,交互演示时请逐条运行。
成功返回 0;输入、输出或参数错误返回 2。自动化只在成功后处理产物,例如:
python3 merge_logs.py worker-a.log worker-b.log -o next-run.jsonl && wc -l next-run.jsonl
5. 验证:检查边界和失败保护
把下面保存为 check_merge.py,在 merge_logs.py 所在目录执行 python3 check_merge.py。测试只在自动清理的独立子目录里创建文件,核对排序、时区、同一时刻、中文、CRLF、末行无换行、空输入、坏编码、乱序、缺失路径及已有输出保护。
import json
from pathlib import Path
import subprocess
import sys
import tempfile

script = Path("merge_logs.py").resolve()
with tempfile.TemporaryDirectory(prefix="merge-check-", dir=".") as folder:
    root = Path(folder)
    a, b, output = [root / name for name in ("a log.txt", "b.log", "result.jsonl")]
    a.write_text("2026-10-28T08:00:00+08:00 alpha\n"
                 "2026-10-28T00:00:02Z 中文", encoding="utf-8")
    b.write_bytes(b"2026-10-28T00:00:00Z beta\r\n"
                  b"2026-10-28T00:00:01Z gamma\r\n")
    original = (a.read_bytes(), b.read_bytes())

    def run(inputs, destination):
        return subprocess.run([sys.executable, str(script), *map(str, inputs),
                               "-o", str(destination)], capture_output=True,
                              text=True, encoding="utf-8")

    result = run([a, b], output)
    assert result.returncode == 0 and json.loads(result.stdout)["records"] == 4
    rows = [json.loads(line) for line in output.read_text(encoding="utf-8").splitlines()]
    assert [r["message"] for r in rows] == ["alpha", "beta", "gamma", "中文"]
    assert [r["line"] for r in rows] == [1, 1, 2, 2]
    assert rows[0]["time"] == rows[1]["time"] == "2026-10-28T00:00:00+00:00"
    assert rows[0]["source"] == str(a) and rows[1]["source"] == str(b)
    saved = output.read_bytes()
    assert run([a, b], output).returncode == 2 and output.read_bytes() == saved
    assert run([a], a).returncode == 2
    assert (a.read_bytes(), b.read_bytes()) == original

    bad = root / "bad.log"
    failures = [
        b"2026-10-28T00:00:02Z later\n2026-10-28T00:00:01Z earlier\n",
        b"2026-10-28T00:00:00 no-offset\n",
        b"not-a-timestamp message\n", b"\n", b"2026-10-28T00:00:00Z\n",
        b"2026-10-28T00:00:00Z \xff\n",
    ]
    for index, payload in enumerate(failures):
        bad.write_bytes(payload)
        target = root / f"failed-{index}.jsonl"
        result = run([a, bad], target)
        assert result.returncode == 2 and not result.stdout and result.stderr
        assert not target.exists() and bad.read_bytes() == payload
    missing = run([root / "missing.log"], root / "missing.jsonl")
    assert missing.returncode == 2 and not (root / "missing.jsonl").exists()
    assert run([a, a], root / "duplicate.jsonl").returncode == 2
    assert run([a] * 65, root / "too-many.jsonl").returncode == 2
    empty = root / "empty.log"
    empty.write_bytes(b"")
    empty_output = root / "empty.jsonl"
    assert run([empty], empty_output).returncode == 0
    assert empty_output.read_bytes() == b""
print("PASS: ordering, offsets, ties, Unicode, line endings, failures, output protection")
这里的空输入指内容为空的输入文件,会生成空 JSONL,报告 0 条记录。时间相同的两条消息仍保留为两条记录;记录总数应与所有输入的有效行数之和相同。对于后续流程,还可以接上 JSONL 逐行校验工具。
6. 排错:错误信息对应的处理
| 错误 | 处理 |
|---|---|
timestamps go backwards |
查看提示路径和行号;按实际时刻预先排序该文件,或修复写入端。不要直接忽略检查。 |
timestamp needs Z or a UTC offset |
从日志源确认时区,补上正确偏移量;不要按服务器当前时区猜测。 |
expected TIMESTAMP message |
删除或修复空记录,把多行堆栈转换成约定的单行格式。 |
File exists |
使用新的输出名;不要删除仍有用途的旧报告。 |
| UTF-8 解码失败 | 核实源文件编码并显式转换,避免用 errors="ignore" 丢掉日志内容。 |
Too many open files 或磁盘空间不足 |
减少同一批的输入数量,检查可用空间;超过 64 份时先分批归并,下一阶段需先转换 JSONL 为本工具的输入格式。 |
本例不是 tail -f,不等待新记录,也不会修正服务器时钟偏差。若同一文件因多线程写入而乱序,必须先整理稳定副本;不能因为所有时间戳格式相同就假定输入有序。
7. 总结
先把时间统一为 UTC,再检查每路日志有序,才能用 heapq.merge 逐条合并。保留来源和行号,并在完整校验后创建新输出,让故障定位更直接。接入自动化时核对退出码和记录数,读取已完成的结果。
- 原文作者:春江暮客
- 原文链接:https://www.bobobk.com/python-merge-sorted-logs-heapq.html
- 版权声明:本作品采用 知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。