Python SQLite IN 查询:动态占位符、空列表与变量上限分批
文章目录
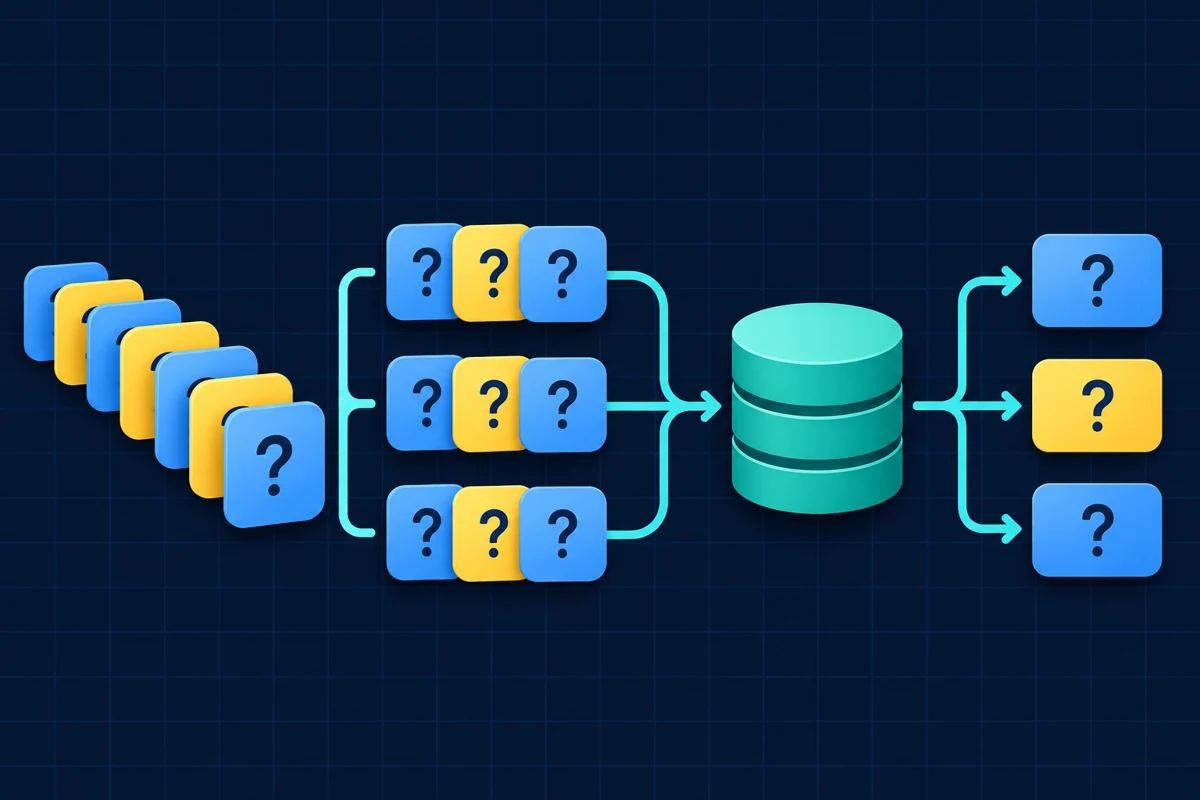
从 CSV 读出一批名称,想用 SQLite 一次查询对应任务,结果把 Python 列表塞进 IN (?) 后报参数类型错误;改成拼字符串,又会在带单引号的名称上出错。本文用标准库写一个可复用的批量查询函数:一个值对应一个占位符,空输入直接返回,并按当前连接的变量上限分批。
示例面向初级到中级读者,数据库始终在内存中创建,不打开现有数据库。它补充了 用 SQLite 排序大型 CSV之后常见的按名称回查需求,不重复数据导入流程。
1. 方法:只拼占位符,不拼数据
IN (?) 中的一个 ? 只能绑定一个值,不会把 Python 列表展开成多项。下面的最小示例捕获并显示这个错误:
python3 - <<'PYCODE'
import sqlite3
from contextlib import closing
with closing(sqlite3.connect(":memory:")) as con:
    con.execute("CREATE TABLE jobs(name TEXT)")
    try:
        con.execute("SELECT name FROM jobs WHERE name IN (?)", (["alpha", "beta"],))
    except sqlite3.ProgrammingError as exc:
        print(type(exc).__name__ + ": " + str(exc))
PYCODE
在本文测试环境中,输出为:
ProgrammingError: Error binding parameter 1: type 'list' is not supported
正确做法是为当前批次生成 ?,?,?,再把值作为 execute() 的第二个参数传入。表名和列名固定;占位符不用于动态表名。Python 参数绑定文档
本例约定:空列表返回 [],重复名称只查询一次,不存在的名称不产生记录,结果按 Python 字符串顺序排列,而不是输入顺序。SQLite 允许 IN (),但这里提前返回,避免执行无意义的查询;不要误认为所有数据库都接受空的 IN 列表。SQLite IN 运算符说明
2. 准备:检查版本,保存脚本
需要 Python 3.11 或更新版本及内置 sqlite3,不需要 pip 包。本文在 Linux、Python 3.11.4、SQLite 3.41.2 上测试。按顺序在同一终端操作,重复练习时换一个新目录名:
python3 --version
python3 -c 'import sqlite3; print(sqlite3.sqlite_version)'
mkdir sqlite-in-demo
cd sqlite-in-demo
将下一节保存为 query_in.py,也可下载完整查询脚本。测试文件放在相同目录。
3. 完整实现:给固定条件预留参数
查询除了名称列表,还有 status = ?,所以可用批次容量是 连接变量上限 - 1,再与 --batch-size 取较小值。SQLite 的编译配置与运行时设置会影响上限,别把 999 写死;通过当前连接的 getlimit() 查询。SQLite 变量数量限制
"""Query a fixed demo schema with bound, limit-aware IN batches. Python 3.11+."""
import argparse
from contextlib import closing
import json
import sqlite3
import sys


def positive_int(text):
    value = int(text)
    if value < 1:
        raise argparse.ArgumentTypeError("must be a positive integer")
    return value


def find_jobs(con, names, status="ready", batch_size=500):
    if batch_size < 1:
        raise ValueError("batch_size must be positive")
    names = list(names)
    if any(not isinstance(name, str) for name in names):
        raise ValueError("names must contain only strings")
    unique = list(dict.fromkeys(names))
    if not unique:
        return []
    # One parameter is reserved for status in every SELECT.
    available = con.getlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER) - 1
    if available < 1:
        raise ValueError("variable limit leaves no room for names")
    size = min(batch_size, available)
    rows = []
    for start in range(0, len(unique), size):
        batch = unique[start:start + size]
        marks = ",".join("?" for _ in batch)
        sql = "SELECT name, status FROM jobs WHERE status = ? AND name IN (" + marks + ")"
        with closing(con.execute(sql, [status, *batch])) as cur:
            rows.extend({"name": name, "status": state} for name, state in cur)
    return sorted(rows, key=lambda row: row["name"])


def demo_connection():
    con = sqlite3.connect(":memory:", isolation_level=None)
    try:
        con.execute("CREATE TABLE jobs(name TEXT PRIMARY KEY NOT NULL, status TEXT NOT NULL)")
        con.executemany("INSERT INTO jobs VALUES (?, ?)", [
            ("alpha", "ready"), ("beta", "done"),
            ("gamma", "ready"), ("o'reilly", "ready"),
        ])
    except BaseException:
        con.close()
        raise
    return con


def main(argv=None):
    parser = argparse.ArgumentParser(description=__doc__, allow_abbrev=False)
    parser.add_argument("names", nargs="*", help="exact names; no names returns []")
    parser.add_argument("--status", choices=["ready", "done"], default="ready")
    parser.add_argument("--batch-size", type=positive_int, default=500)
    args = parser.parse_args(argv)
    try:
        with closing(demo_connection()) as con:
            rows = find_jobs(con, args.names, args.status, args.batch_size)
    except (sqlite3.Error, ValueError) as exc:
        print(f"ERROR: {exc}", file=sys.stderr)
        return 1
    print(json.dumps(rows, ensure_ascii=False, sort_keys=True))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
getlimit() 和后面测试用的 setlimit() 从 Python 3.11 开始提供;后者仅调整该连接,返回原来的限制值。Python 连接限制接口
注意三个实现细节:
dict.fromkeys()在分批前去重,避免跨批重复返回同一行。本例固定 schema 使用默认的 BINARY 文本比较;若业务采用不区分大小写的排序规则,需要重新定义去重语义。- 所有名称,包括
o'reilly,都作为绑定值传入;marks里只有程序生成的问号和逗号。 closing()关闭游标和连接;连接上下文管理器的事务提交/回滚行为不等于关闭连接。
这是有上限的查询批次,不是无限内存的流式处理:名称、去重集合与结果仍保存在内存中。百万级输入宜改用临时表加 JOIN,并单独设计结果流与事务。
4. 运行与验证
执行:
python3 query_in.py --help
python3 query_in.py alpha "o'reilly" gamma alpha missing --batch-size 2
python3 query_in.py
python3 query_in.py alpha beta --status done
第一条显示帮助,后三条依次输出:
[{"name": "alpha", "status": "ready"}, {"name": "gamma", "status": "ready"}, {"name": "o'reilly", "status": "ready"}]
[]
[{"name": "beta", "status": "done"}]
三种查询都返回 0;没有匹配记录也是有效结果。参数错误返回 2,查询或数据库错误返回 1,错误写入标准错误。--batch-size 2 只是每批名称数,不包含单独预留的 status 参数。
若后续要更新查到的任务,可接着读 用 UPSERT 更新而不是 REPLACE,不要把本例的 SELECT 字符串直接替换成多批写入。
5. 自动测试:主动压低限制,验证分批
将下面内容保存为 test_query_in.py,也可下载测试文件。测试把内存连接的变量上限临时降到 3:每条语句一个 status,加两个名称,因此四个不同名称必须分成两次 SELECT。
"""Run with python3 -m unittest -v test_query_in.py."""
from contextlib import closing
import sqlite3
import subprocess
import sys
import unittest

from query_in import demo_connection, find_jobs


class QueryTests(unittest.TestCase):
    def test_empty_skips_select(self):
        with closing(demo_connection()) as con:
            trace = []
            con.set_trace_callback(trace.append)
            self.assertEqual(find_jobs(con, []), [])
            self.assertEqual(trace, [])

    def test_single_quote_duplicate_and_missing(self):
        with closing(demo_connection()) as con:
            rows = find_jobs(con, ["o'reilly", "alpha", "alpha", "missing"], batch_size=1)
            self.assertEqual([r["name"] for r in rows], ["alpha", "o'reilly"])

    def test_status_filter(self):
        with closing(demo_connection()) as con:
            self.assertEqual(find_jobs(con, ["alpha", "beta"], "done"),
                             [{"name": "beta", "status": "done"}])

    def test_sql_text_is_just_data(self):
        with closing(demo_connection()) as con:
            self.assertEqual(find_jobs(con, ["x') OR 1=1 --"]), [])
            self.assertEqual(con.execute("SELECT count(*) FROM jobs").fetchone(), (4,))

    def test_lowered_limit_and_reserved_parameter(self):
        with closing(demo_connection()) as con:
            category = sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER
            previous = con.setlimit(category, 3)
            trace = []
            con.set_trace_callback(trace.append)
            try:
                rows = find_jobs(con, ["alpha", "beta", "gamma", "o'reilly"], batch_size=500)
                self.assertEqual(len(rows), 3)
                self.assertEqual(len(trace), 2)
            finally:
                con.setlimit(category, previous)
            self.assertEqual(con.getlimit(category), previous)

    def test_no_parameter_room(self):
        with closing(demo_connection()) as con:
            con.setlimit(sqlite3.SQLITE_LIMIT_VARIABLE_NUMBER, 1)
            with self.assertRaisesRegex(ValueError, "no room"):
                find_jobs(con, ["alpha"])

    def test_invalid_input(self):
        with closing(demo_connection()) as con:
            with self.assertRaises(ValueError):
                find_jobs(con, [1])
            with self.assertRaises(ValueError):
                find_jobs(con, ["alpha"], batch_size=0)

    def test_cli(self):
        from pathlib import Path
        script = str(Path(__file__).with_name("query_in.py"))
        ok = subprocess.run([sys.executable, script, "alpha"], capture_output=True, text=True)
        self.assertEqual(ok.returncode, 0)
        self.assertIn('"name": "alpha"', ok.stdout)
        bad = subprocess.run([sys.executable, script, "--batch-size", "0"],
                             capture_output=True, text=True)
        self.assertEqual(bad.returncode, 2)
        self.assertEqual(bad.stdout, "")


if __name__ == "__main__":
    unittest.main()
运行测试,再检查非法批次大小的退出码:
python3 -m unittest -v test_query_in.py
python3 query_in.py --batch-size 0
printf 'exit=%s\n' "$?"
测试应显示 Ran 8 tests 和 OK;最后一条打印 exit=2。测试覆盖空输入不执行 SELECT、引号、重复和缺失名称、状态过滤、类似 SQL 的普通文本、固定参数预算、非法输入及 CLI。低限制测试在 finally 中恢复原值,不修改系统或数据库文件。
6. 排错与边界
| 现象 | 原因与操作 |
|---|---|
type 'list' is not supported |
一个问号收到整个列表;改为本例的逐值占位符与展开后的参数序列。 |
Incorrect number of bindings supplied |
问号数和值数不一致;把 [status, *batch] 和对应 SQL 一起检查。 |
too many SQL variables |
实际 SQL 还有其他绑定条件;从连接上限中减去全部固定参数数目,再决定每批容量。 |
Connection 没有 getlimit |
运行解释器早于 Python 3.11;用 python3 --version 核对实际命令。 |
| 查询结果的顺序与输入不同 | IN 只表达集合匹配;本例显式按名称排序。需要输入顺序时另建位置映射。 |
| 多批读取时数据发生变化 | 本例内存库没有并发写入。接入现有库且要求一致快照时,由调用方在查询前显式 BEGIN,结束后 ROLLBACK 或 COMMIT,并处理锁等待。 |
不要把 NOT IN 简单套进这套分批拼接逻辑:各批的排除结果不能直接合并成完整排除结果。名称包含 NULL、非字符串或自定义排序规则时,也需要另外确定匹配语义。现有数据库的连接与锁问题可参考 SQLite database is locked 排查。
7. 总结
批量 IN 查询要分清 SQL 结构与数据:代码只生成占位符,值始终通过参数绑定。先处理空输入和重复值,再按连接限制减去固定参数预算分批,并用压低限制的内存测试验证。接入并发数据库前,另外决定快照、排序与内存规模,别把分批误当成事务保障。
- 原文作者:yanzhi
- 原文链接:https://www.bobobk.com/python-sqlite-in-query-batching.html
- 版权声明:本作品采用 知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议 进行许可。非商业转载请注明作者与原文链接,商业转载请联系作者获得授权。