用 Python 按 ID 比较两份 CSV:找出新增、删除和字段修改
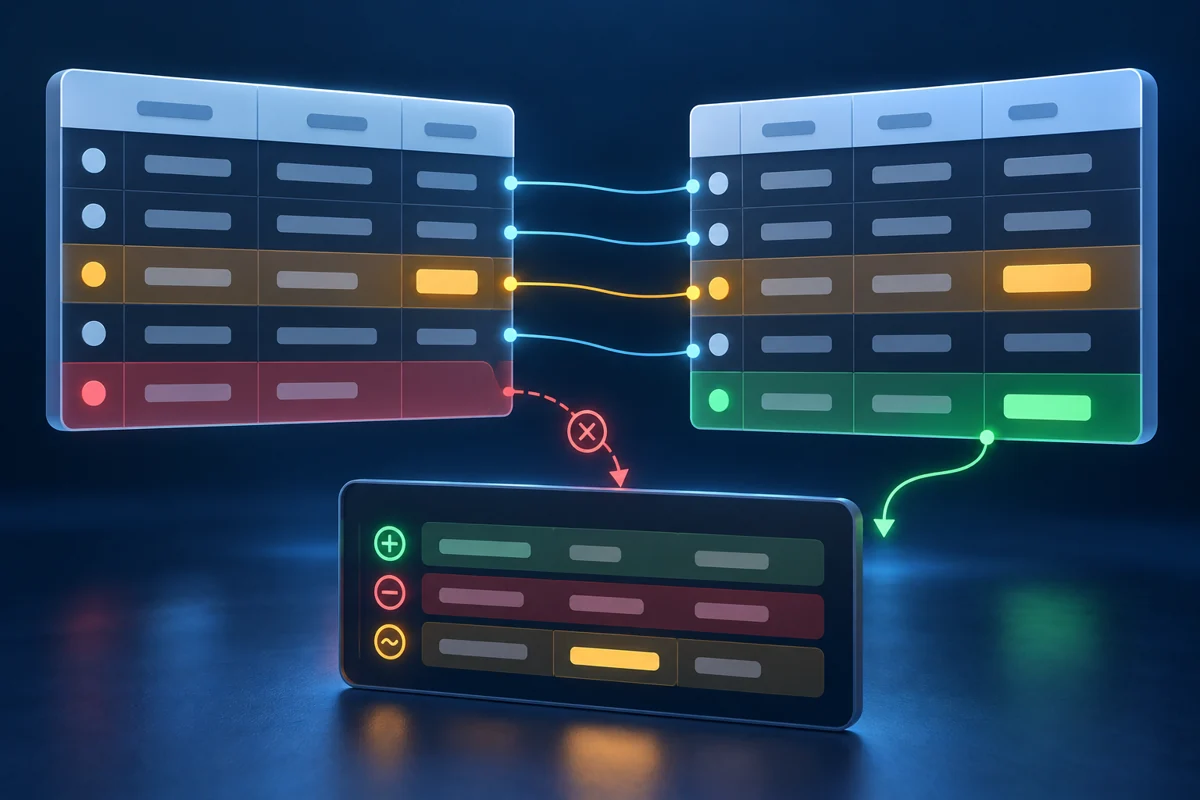
每天导出的 CSV 行数相同,内容也可能已经变化。直接用文本 diff,又会把记录顺序调整当作大量修改,难以看出真正变动的数据。
本文为初级到中级读者提供一个只用 Python 标准库的命令:按唯一 ID 对齐两份 CSV,输出新增 ID、删除 ID 和字段修改,再用退出码区分“相同”“有差异”和“检查失败”。适合能同时放入内存的配置表、样本清单和每日导出快照。
1. 方法:先约定比较规则
- 两份文件都是逗号分隔的 UTF-8 CSV,允许开头有 BOM;表头名称及顺序必须一致,列名非空、无首尾空白且不重复。
- 默认用
sample_id作为唯一键,可以通过--key修改。拒绝空键、首尾带空白的键和重复键,避免字典覆盖旧记录。 - 数据行顺序不参与比较;字段按解析后的原始字符串比较。
001与1是不同 ID,1与1.0是不同值,普通字段中的空白和换行也保留。 - 只有表头的文件有效,完全空白的文件无效。键本身改名会表现为一个删除和一个新增;本例不支持复合键或数值误差容限。
先做CSV 结构校验,有助于把列格式问题与数据变动分开。大文件需要另行设计磁盘索引或外部排序;本例会保存两份完整数据和差异报告,内存用量随输入及差异增加。
2. 准备环境和两份快照
需要 Python 3.9 或更新版本,无需 pip 包。下面示例在 Linux、Python 3.11.4 上验证,shell 命令适用于 Bash 或 zsh。
- 新建演示目录,后续命令都在这里运行。重复操作时换一个目录名,避免覆盖文件:
python3 --version
mkdir csv-diff-demo
cd csv-diff-demo
- 创建两个小文件。新快照调整了行顺序,修改
001的标签,删除002,新增004:
cat > old.csv <<'CSV'
sample_id,label,note
001,0,stable
002,1,removed
003,1,keep
CSV
cat > new.csv <<'CSV'
sample_id,label,note
003,1,keep
001,1,stable
004,0,added
CSV
- 将下一节保存为
compare_csv.py,也可以下载完整脚本。报告文件必须使用独立路径;shell 的>会在 Python 启动前清空目标,不能重定向到任何输入文件。
3. 实现:按键建立索引后比较
"""Compare two CSV snapshots by one unique key. Python 3.9+, standard library."""
import argparse
import csv
import json
from pathlib import Path
import sys


def load_csv(path, key):
    records = {}
    with open(path, encoding="utf-8-sig", newline="") as handle:
        reader = csv.reader(handle, strict=True)
        header = next(reader, None)
        if not header or any(not name or name != name.strip() for name in header):
            raise ValueError(f"{path}: empty or padded column name")
        if len(set(header)) != len(header) or key not in header:
            raise ValueError(f"{path}: columns must be unique and include {key!r}")
        key_index = header.index(key)
        for number, row in enumerate(reader, 1):
            if len(row) != len(header):
                raise ValueError(f"{path}: record {number}: wrong field count")
            identity = row[key_index]
            if not identity or identity != identity.strip():
                raise ValueError(f"{path}: record {number}: empty or padded key")
            if identity in records:
                raise ValueError(f"{path}: record {number}: duplicate key {identity!r}")
            records[identity] = dict(zip(header, row))
    return header, records


def compare(old_path, new_path, key):
    old_header, old = load_csv(old_path, key)
    new_header, new = load_csv(new_path, key)
    if old_header != new_header:
        raise ValueError("headers differ: column names and order must match")
    added = sorted(new.keys() - old.keys())
    removed = sorted(old.keys() - new.keys())
    changed = []
    for identity in sorted(old.keys() & new.keys()):
        fields = {
            name: {"old": old[identity][name], "new": new[identity][name]}
            for name in old_header
            if old[identity][name] != new[identity][name]
        }
        if fields:
            changed.append({"id": identity, "fields": fields})
    return {"key": key, "added": added, "removed": removed, "changed": changed}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("old", type=Path)
    parser.add_argument("new", type=Path)
    parser.add_argument("--key", default="sample_id", help="unique key column")
    args = parser.parse_args()
    try:
        report = compare(args.old, args.new, args.key)
        json.dump(report, sys.stdout, ensure_ascii=True, indent=2)
        sys.stdout.write("\n")
        sys.stdout.flush()
    except (OSError, UnicodeError, ValueError, csv.Error) as exc:
        parser.exit(2, f"error: {exc}\n")
    return int(any(report[name] for name in ("added", "removed", "changed")))


if __name__ == "__main__":
    sys.exit(main())
这里用 csv.reader 处理引号、逗号和跨行字段,并在构造字典前显式校验表头、字段数和键唯一性。strict=True 只覆盖解析器识别的坏格式,不是完整的业务校验;newline="" 的用法见 Python 官方 CSV 文档。记录编号从表头后的第一条记录开始,不是物理行号。
added、removed 和 changed 都按 ID 字符串排序,便于重复检查。新增与删除只列 ID,修改列出变化字段的旧值和新值;JSON 中的 id 始终是所选键的值,即使使用了其他键列名。报告用标准库的 json.dump 输出,非 ASCII 字符转义后仍能无损解析。
只有两份输入全部通过校验才开始输出 JSON。写入报告时出错仍可能留下部分内容,因此必须检查退出码;该脚本没有实现原子保存,也不会锁定正在被其他程序改写的输入。使用已经完成导出的稳定快照。
4. 执行并查看结果
python3 compare_csv.py --help
if python3 compare_csv.py old.csv new.csv --key sample_id > diff.json; then
  result=0
else
  result=$?
fi
printf 'exit=%s\n' "$result"
cat diff.json
预期 exit=1,表示成功完成比较且发现差异。JSON 的缩进可能与下面展示不同,数据应为:
{
  "key": "sample_id",
  "added": ["004"],
  "removed": ["002"],
  "changed": [
    {"id": "001", "fields": {"label": {"old": "0", "new": "1"}}}
  ]
}
003 没有出现在报告中,因为只是位置变了。退出码约定如下;它是本脚本的接口,整数退出状态的行为见 sys.exit 官方文档。
| 退出码 | 含义 | 后续操作 |
|---|---|---|
| 0 | 两份输入有效,按键比较相同 | 可以继续无变动流程 |
| 1 | 两份输入有效,发现新增、删除或修改 | 查看报告,决定是否接受变化 |
| 2 | 参数、输入或处理中的 I/O 错误 | 修复错误后重跑,不使用本次报告 |
5. 验证差异、排序变化与坏输入
把下面保存为 check_diff.py,执行 python3 check_diff.py。它核对演示报告,并确认只调整行顺序或增加 BOM 不算变动,重复键返回 2 且不输出 JSON:
import csv
import json
import subprocess
import sys

with open("diff.json", encoding="utf-8") as handle:
    report = json.load(handle)
assert report == {
    "key": "sample_id",
    "added": ["004"],
    "removed": ["002"],
    "changed": [{"id": "001", "fields": {"label": {"old": "0", "new": "1"}}}],
}
with open("old.csv", encoding="utf-8", newline="") as handle:
    rows = list(csv.reader(handle))
with open("reordered.csv", "w", encoding="utf-8-sig", newline="") as handle:
    writer = csv.writer(handle)
    writer.writerow(rows[0])
    writer.writerows(reversed(rows[1:]))
result = subprocess.run(
    [sys.executable, "compare_csv.py", "old.csv", "reordered.csv"],
    text=True, capture_output=True, check=False,
)
assert result.returncode == 0, result.stderr
assert json.loads(result.stdout) == {
    "key": "sample_id", "added": [], "removed": [], "changed": [],
}
with open("duplicate.csv", "w", encoding="utf-8", newline="") as handle:
    csv.writer(handle).writerows([rows[0], rows[1], rows[1]])
result = subprocess.run(
    [sys.executable, "compare_csv.py", "old.csv", "duplicate.csv"],
    text=True, capture_output=True, check=False,
)
assert result.returncode == 2
assert "duplicate key" in result.stderr
assert result.stdout == ""
print("PASS: changes, row order, BOM, and duplicate rejection")
预期输出 PASS: changes, row order, BOM, and duplicate rejection。验证中的文件都在演示目录内创建;它不会修改两份原始快照。
6. 接入自动化与排障
在定时任务或 CI 中,set -e 会让退出码 1 也中断脚本。用 if 接住状态,再明确处理,下面可以保存为 check_snapshot.sh,通过 bash check_snapshot.sh 运行:
#!/usr/bin/env bash
set -eu
if python3 compare_csv.py old.csv new.csv --key sample_id > diff.json; then
  echo "No record changes"
else
  result=$?
  case "$result" in
    1) echo "Records changed; review diff.json" >&2 ;;
    *) echo "Comparison failed; do not use diff.json" >&2 ;;
  esac
  exit "$result"
fi
本例把“有差异”继续作为退出码 1 交给上层,便于要求人工检查的任务暂停。它不是自动批准变更的策略;检查失败时,已有的 diff.json 也不能当成可用结果。
| 问题 | 具体处理 |
|---|---|
duplicate key |
回到源数据核查;可先用重复 ID 检查工具定位,不要随意保留最后一条。 |
headers differ |
核对列名和顺序,按共同的明确格式重新导出。 |
wrong field count 或 CSV 错误 |
检查分隔符、引号和字段内逗号;本例不自动猜测格式。 |
| 编码错误 | 按CSV 编码排障方法确认来源编码,严格转成 UTF-8 后重跑。 |
| 大字段被解析器拒绝 | 核查输入是否异常,再有意识地调整 csv.field_size_limit。 |
| 进程内存不足或被系统终止 | 减小输入规模,或改成磁盘索引方案;不要只以报告文件存在判断成功。 |
7. 总结
按稳定的唯一 ID 对齐记录,可以把顺序变化与数据变化分开。先校验输入,再检查退出码,最后查看新增、删除和字段修改报告。这个内存版脚本适合小到中等规模快照,数据量较大时应换用磁盘索引方案。
- 原文作者:春江暮客
- 原文链接:https://www.bobobk.com/python-csv-diff-by-key.html
- 版权声明:本作品采用 知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。